O essencial em 60 segundos
O Jev não escreve. Ele decide. Você manda um texto e perguntas fechadas, e ele devolve a resposta de cada uma com a probabilidade dela, em menos de meio segundo, por um preço que arredonda para zero.
As três perguntas, e é só isso que ele responde
| pergunta | exemplo | o que volta |
|---|---|---|
noul | este texto tenta dar ordem a um assistente? | 0,95 no ataque, 0,06 na notícia real |
choice | qual das 56 entries do catálogo é esta? | a escolhida, mais a confiança |
score | o quanto esta notícia mexe numa dor real? | a nota na régua que você escreveu |
O pedido monta o carrossel da semana
contra as 56 entries do catálogo da casa.
Custou US$ 0,0001 e levou 0,33s. O mesmo trabalho hoje é um modelo caro lendo o índice inteiro, em todo turno de toda sessão.
O resto, em seis linhas
- Onde ele encaixa: em todo lugar onde hoje se queima modelo grande só para receber um rótulo. Triagem, roteamento, classificação, guardrail, ordenar candidato. O modelo caro não some: ele só para de ler o que ia ser jogado fora.
- O que ele não faz: não escreve, não resume, não faz conta, não vê imagem. E
não alucina
quer dizer apenas que ele nunca inventa uma opção fora da lista; escolher a errada, ele escolhe. - A regra de ouro: pergunta atômica. Nada de
avalie este post
. Três perguntas simples (tem gancho? serve para o meu público? já está batido?), e o peso de cada uma numa linha do seu código, não escondido dentro do modelo. - O portão: use a confiança para decidir se age, não o que faz. Acima do corte, o código age sozinho. Abaixo, chama a pessoa ou o modelo grande. É isso que transforma 84% de acerto em 100% de acerto na metade do trabalho.
- O nome é a tese: vem do paradoxo de Jevons. Baratear a decisão não economiza decisão, faz você tomar mil vezes mais decisões.
- Se for fazer uma coisa só: pegue uma decisão que a sua operação já toma cem vezes por semana, junte cem casos cuja resposta certa você já tem de graça, e meça acerto, custo e tempo contra o que roda hoje.
Quase todo número que circula é da própria TypeSafe, não existe paper nem avaliação de terceiro em conjunto padrão, e o contrato deles proíbe publicar benchmark do serviço.
Uso interno não tem problema nenhum. Publicar comparativo com o nome deles é outra conversa, e a seção 15 detalha.
Em uma tela
Jev é um modelo que não escreve. Você manda um texto e uma lista de perguntas fechadas. Ele devolve as respostas, cada uma com a probabilidade dela.
Não conversa, não resume, não explica. Só decide.
- token
- O pedaço de palavra que os modelos contam para cobrar. Mil palavras dão mais ou menos 1.300 tokens. Um e-mail médio dá uns 300.
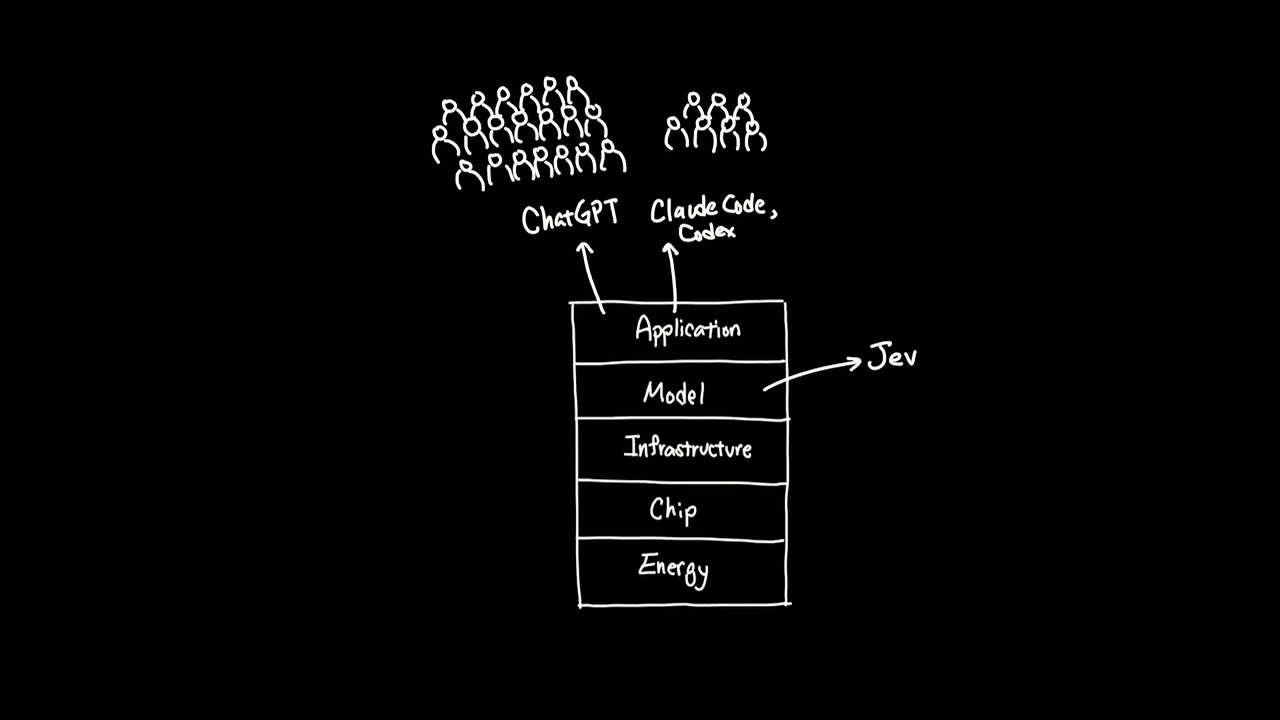
Quem fez: Diogo Almeida, ex-OpenAI, um dos autores principais do paper do InstructGPT, o trabalho que virou o ChatGPT. Ele passou 2 anos em silêncio construindo isto. A empresa é a TypeSafe AI, e o lema dela é uma alfinetada.
we're building prod, not god
o lema da TypeSafe: estamos construindo produção, não deus
O antes e depois, no mesmo caso
com um LLM comum
- você escreve:
leia este e-mail e diga se é urgente, responda só com JSON
- espera 3 segundos
- recebe um texto, faz o parse, torce pra não vir quebrado
- paga pelo texto que ele escreveu
com o Jev
- você manda o e-mail e a pergunta
isto é urgente?
- recebe
0.92em 300 milissegundos - não tem parse, não tem JSON quebrado
- e o 0,92 quer dizer alguma coisa
O teste de uma frase: isto é assistência ou automação?
Este é o modelo mental que faz o resto encaixar. A pergunta é uma só: o fluxo tem humano no meio?
se tem humano no meio
- é assistência
- o objetivo é agradar quem está lendo
- ChatGPT, Claude Code, Cursor
- a IA de hoje é sobre-humana nisto
se não tem
- é automação
- o objetivo é a decisão estar certa
- triagem, roteamento, classificação, guardrail
- a IA de hoje é fraca nisto
E não é acidente. É o que foi otimizado.
Agente de código é assistência, por mais técnico que pareça. A pergunta de Almeida que prova isso: você confiaria num agente de código sem controle de versão? O controle de versão é o humano no laço. Código é uma linguagem para humanos, não para máquinas.
Suporte ao cliente sem decisão contra suporte ao cliente com decisão. Existe um monte de chatbot de suporte por aí, e nenhum deles executa ação. Eles jogam a pessoa no labirinto da documentação.
Não é incompetência: o custo do erro está no usuário, não na empresa. No dia em que a ação custa dinheiro da empresa, o humano volta pro laço.
Não use a IA de hoje para decisão com consequência.
Por que isso existe
Três siglas, e só a terceira é nova
| método | otimiza para | o que produziu |
|---|---|---|
| RLHF | preferência humana | assistência (ChatGPT) |
| RLVR | correção verificável | agente de código (Claude Code) |
| RLCD | decisão calibrada | automação (Jev) |
- RLHF
- Aprendizado por reforço com feedback humano. Mostra duas respostas pra uma pessoa, ela escolhe a melhor, e o modelo aprende a produzir a que seria escolhida.
- RLVR
- O mesmo, mas a recompensa é um teste automático que passa ou falha.
- RLCD
- Aprendizado por reforço para decisões calibradas. Calibrada quer dizer: quando ele diz 80%, ele acerta perto de 80% das vezes.
O mecanismo: colapso de modo
Aqui está a explicação de uma coisa que todo mundo sente e ninguém sabe nomear: por que a resposta de um LLM quase sempre parece certa, mesmo quando está errada.
Quando o espaço de otimização é difícil demais, o modelo precisa escolher o formato dos próprios erros. Existem dois formatos:
cobrir os modos
- ficar no meio termo entre as possibilidades
- é o que o pré-treino faz
- é por isso que modelo cru é criativo e imprevisível
derrubar os modos
- diante de duas possibilidades, ir na segura
- é o que o RLHF faz
- é uma escolha de projeto, não um defeito
Mandaram pro ChatGPT um áudio de som de pum perguntando o que achou da música que eu fiz
, e receberam uma análise séria e elogiosa.
Não é bug. É o objetivo funcionando como foi desenhado.
A virada que muda tudo para automação
Yann LeCun tem um argumento famoso de que os LLMs estão condenados: se cada token tem uma chance de errar, uma sequência longa erra exponencialmente.
Na prática não acontece. O motivo é justamente o colapso de modo: o modelo sempre pega a saída segura, então não diverge.
Mas o argumento do LeCun volta a valer quando você encadeia decisões. Uma decisão plausível serve. Dez mil decisões encadeadas, cada uma apoiada na anterior, não sobram.
É por isso que automação de verdade não se resolve com um LLM melhor.
A prova histórica de que a tarefa vale mais que o tamanho
Este é o argumento mais forte do dossiê inteiro, e é histórico, não promessa.
E prompt bem feito no GPT-3 nem chegava perto. Foi o mesmo cara que fez. É o precedente exato do que ele está tentando repetir agora.
A lição que ele tira, contra o bitter lesson
do Sutton (que diz que computação importa mais que algoritmo): dado importa mais que computação, e fazer a tarefa certa importa mais que dado.
Em seis anos e meio de LLM, ele conta uma vez e meia em que alguém acertou a tarefa: o RLHF, e meio crédito pro RLVR. É raro, e nunca é óbvio na hora.
De onde vem o nome
Do paradoxo de Jevons: quando um recurso fica mais eficiente, o consumo total dele aumenta em vez de cair.
O nome é a tese. Baratear a decisão não economiza decisão. Faz você tomar mil vezes mais decisões.
As três perguntas que ele responde
São só três. Tudo se constrói em cima delas.
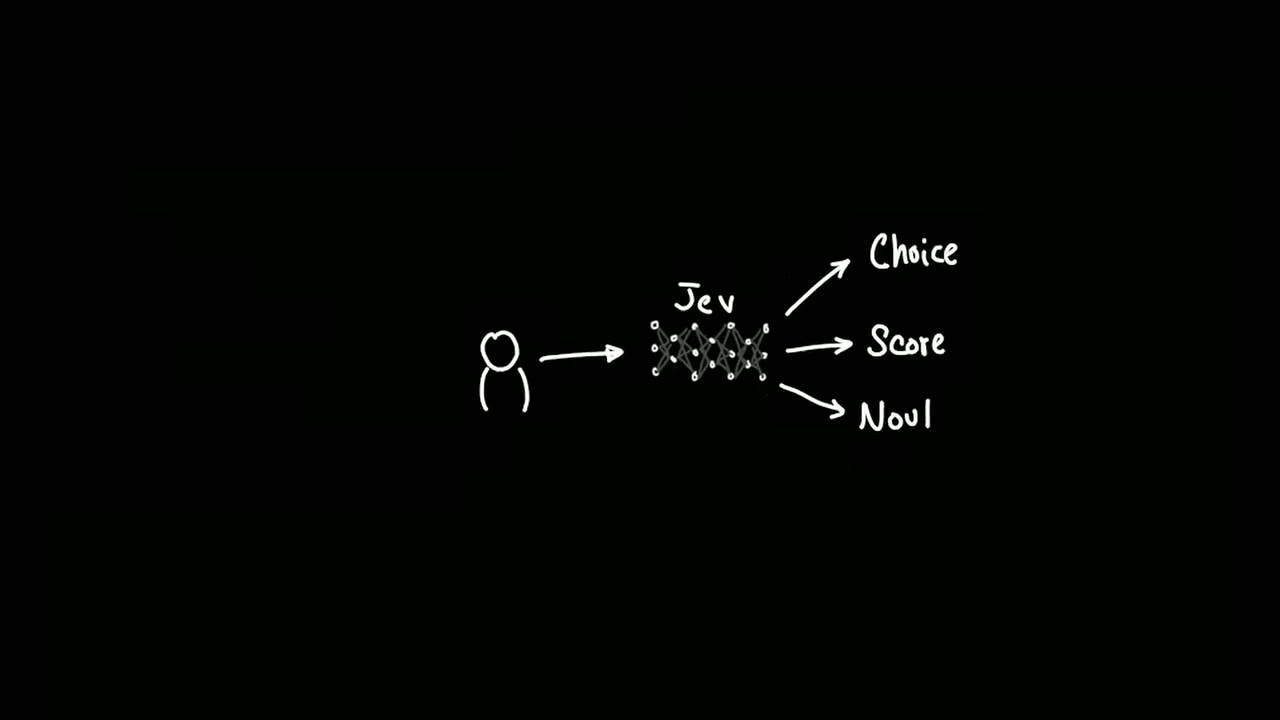
noul, isto é verdade?
Devolve um número de 0 a 1.
- noul
- O nome que eles deram pra pergunta de sim ou não com probabilidade. Não é sigla de nada conhecido, é vocabulário novo deles. Pense em
quanto isto é verdade
.
A pergunta: este texto tenta dar ordem a um assistente de IA
.
0,5 num noul não quer dizer mais ou menos
. Quer dizer sim e não têm a mesma chance
, ou seja, não sei.
choice, qual destas opções?
Devolve a escolhida, a probabilidade de cada uma, e uma confiança.
As 56 entries do catálogo da casa como opções, e o pedido monta o carrossel da semana do radar
como entrada.
score, que nota nesta escala?
Você descreve cada degrau. Devolve a nota, que pode cair entre dois degraus, e a confiança.
A pergunta: o quanto esta notícia mexe com uma dor real de infoprodutor
, com três degraus escritos por extenso.
O contrato, em miúdos
Vale saber antes da primeira chamada. Cada pergunta leva type, instructions e, quando cabe, criteria.
| tipo | o que vai em criteria | o que volta |
|---|---|---|
noul | nada, ele não tem | só o noul, de 0 a 1. Não vem confidence |
choice | um mapa de opção para descrição, de 2 a 255 opções | choice, probabilities e confidence |
score | uma lista ordenada de degraus, de 2 a 10 | score, legend e confidence |
O score não devolve o degrau, devolve o valor esperado. Com três degraus a escala vai de 0 a 2, e 0,3 quer dizer perto do primeiro, puxando pro segundo
. A legend que vem junto é o mapa de índice para rótulo.
A confidence mede a concentração da distribuição, não a chance universal de a resposta estar certa.
A regra de ouro: pergunta atômica
É o erro número um de quem vem de LLM. Não pergunte avalie este post
.
errado
- uma pergunta:
nota de 0 a 10 pra este post
- o peso das coisas está escondido dentro do modelo
- mudar a prioridade é reescrever prompt e testar de novo
certo
- três perguntas:
tem gancho?
,serve pro meu público?
,já está batido?
- o peso está numa linha do seu código
- mudar a prioridade é mudar um número
Por que isso importa no dia a dia: quando a prioridade muda, as notas cruas continuam valendo. Você não gasta chamada nenhuma pra mudar de ideia.
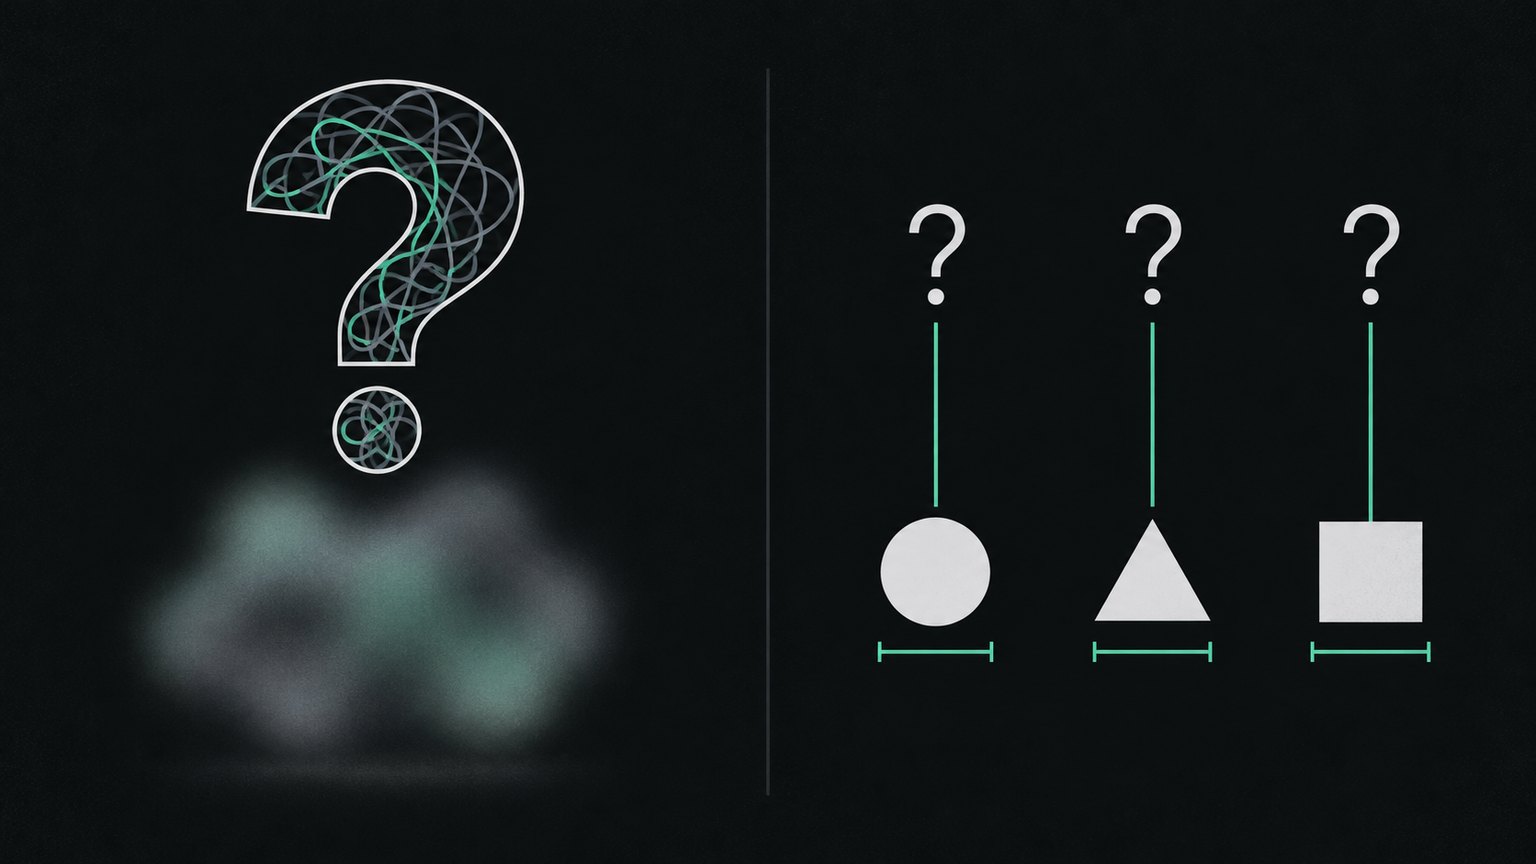
Todas as perguntas vão numa chamada só. São avaliadas em paralelo contra o mesmo texto e não enxergam umas às outras. Acrescentar pergunta quase não muda o tempo.
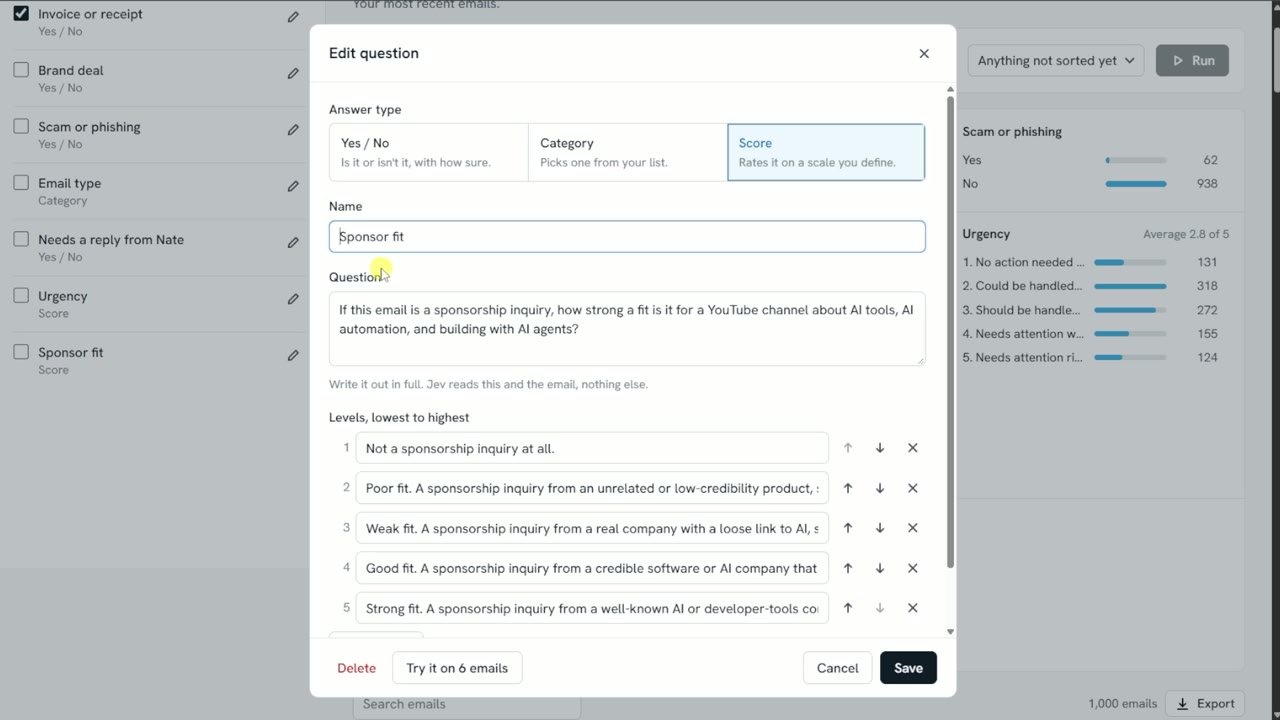
Escrever a pergunta certa: o manual
A regra atômica é o começo. Isto aqui é o resto, e sai todo da documentação deles. É a parte mais acionável do dossiê: dá pra aplicar hoje.
Mande todas as perguntas numa chamada só. É o maior ganho que existe.
Eles mediram, num artigo de 53.777 caracteres com 13 perguntas (8 noul, 2 choice, 3 score):
| como você chama | custo | tempo |
|---|---|---|
| as 13 perguntas numa chamada | US$ 0,000497 | 0,27s |
| 13 chamadas de uma pergunta | US$ 0,006090 | 2,71s |
É esse terceiro número que fecha o argumento: juntar não custa acurácia. O texto entra uma vez só, e as perguntas rodam em paralelo contra ele. Mandar 13 perguntas separadas é pagar o texto 13 vezes.
O ganho de 10x no tempo soma as 13 chamadas em série. Disparando em paralelo, o ganho de tempo encolhe. O de custo continua.
A única regra: só junte perguntas independentes. Se a segunda depende da resposta da primeira, aí são duas chamadas mesmo.
Mande perguntas especulativas, elas saem de graça
Como acrescentar pergunta quase não muda o tempo, mande também as que só importam num ramo. Exemplo deles: num ticket, pergunte a categoria e, junto, a gravidade do bug e se houve pedido de reembolso. Se a categoria vier pedido de funcionalidade
, seu código simplesmente ignora as outras duas.
A árvore de decisão inteira sai de uma chamada. O roteamento vive no if do seu código, não na pergunta.
O texto vai como objeto, não como string
A recomendação é explícita: use objeto JSON com campos nomeados na maioria dos casos. String só quando é um texto único e simples. E aponte a pergunta pro campo exato, com crase:
As mensagens em
suporte.tickets[0] e as cobranças em loja.pedidos[0] indicam cobrança duplicada?
Junte no mesmo texto o que a decisão precisa comparar (o ticket, o pedido e a política de reembolso juntos). Mas mande só o que a pergunta precisa: a acurácia cai quando entra coisa que não interessa.
Como escrever as opções de um choice
- Use os mesmos campos em todas as opções. Em vez de um parágrafo solto por opção, dê a cada uma a mesma estrutura: o que é, o que não é, exemplos.
- O
o que não é
é o que afia a fronteira. É ele que separa sósia de sósia. - Taxonomia profunda: uma pergunta por nível, com as opções sendo os filhos daquele nó. As probabilidades dizem se vale explorar dois ramos.
O limite de opções, e onde a casa cai nele
Acima disso, divida em blocos, rankeie cada bloco, e rode uma segunda passada sobre os vencedores. Para calibrar, com os três catálogos que aparecem neste dossiê:
| catálogo | quantas opções | cabe numa chamada? |
|---|---|---|
| as entries da casa | 56 | folgadas |
| as skills do Hermes | 182 | folgadas |
| as notas do vault | 1.312 | precisam de blocos |
Confiança não é a probabilidade do primeiro colocado
Parece a mesma coisa e não é. A confiança separa estas duas situações, a probabilidade do vencedor não.
vencedor com 0,45
- o segundo colocado está com 0,44
- é um empate: tem sósia na lista
vencedor com 0,45
- o resto está espalhado fino
- o vencedor está sozinho na frente
O truque de responder mais grosso quando não sabe
Este é esperto e quase ninguém faz. Em vez de errar fino ou calar, responda no nível de cima da sua taxonomia.
Eles classificaram 60 relatórios anuais em 75 grupos de indústria:
| política | o que ele responde | acertos |
|---|---|---|
| forçando o grupo sempre | o grupo de indústria | 39 de 60 |
| com o corte, acima de 0,9 | o grupo de indústria | 27 de 30 |
| com o corte, abaixo de 0,9 | a divisão, o nível acima | 21 de 30 |
Não precisa de chamada nova. O rótulo largo se deriva do estreito, no seu código.
As faixas de revisão que eles publicam
| faixa | o que fazer |
|---|---|
| abaixo de 0,30 | trata como não |
| de 0,30 a 0,70 | manda pra pessoa |
| acima de 0,70 | trata como sim |
Para choice, o corte que eles usaram foi probabilidade do primeiro acima de 0,60. O efeito medido: a concordância de rótulo sobe de 90,8% para 99,2%, e o sistema ainda age sozinho em 74,2% dos casos.
Os números são ilustrativos. O certo é plotar confiança contra acerto nos seus dados.
Duas regras curtas pra fechar
- Escreva toda pergunta de forma que
sim
seja a coisa checada. Se metade das suas perguntas responde sim para o bom e a outra metade responde sim para o ruim, você não consegue comparar as linhas entre si. Padronize o sentido. - Fixe a versão do modelo.
jev-latesté apelido, e apelido anda. Se você calibrou um corte de confiança, fixejev-1.13.0.
O portão de confiança
Isto é o que separa brinquedo de produção.
Toda resposta de choice e de score vem com uma confiança de 0 a 1. Ela mede o quanto a probabilidade está concentrada numa opção só.
Use a confiança pra decidir se age, não o que faz:
| confiança | o que o código faz |
|---|---|
| alta | age sozinho |
| média | age, mas pede confirmação ou marca pra revisão |
| baixa | não age: manda pra pessoa, ou pro modelo grande |
Onde você põe os cortes depende do estrago que o erro causa. Ler errado é recuperável. Apagar errado não é.
A outra metade dos pedidos sobe pro modelo caro, como sempre subiu.
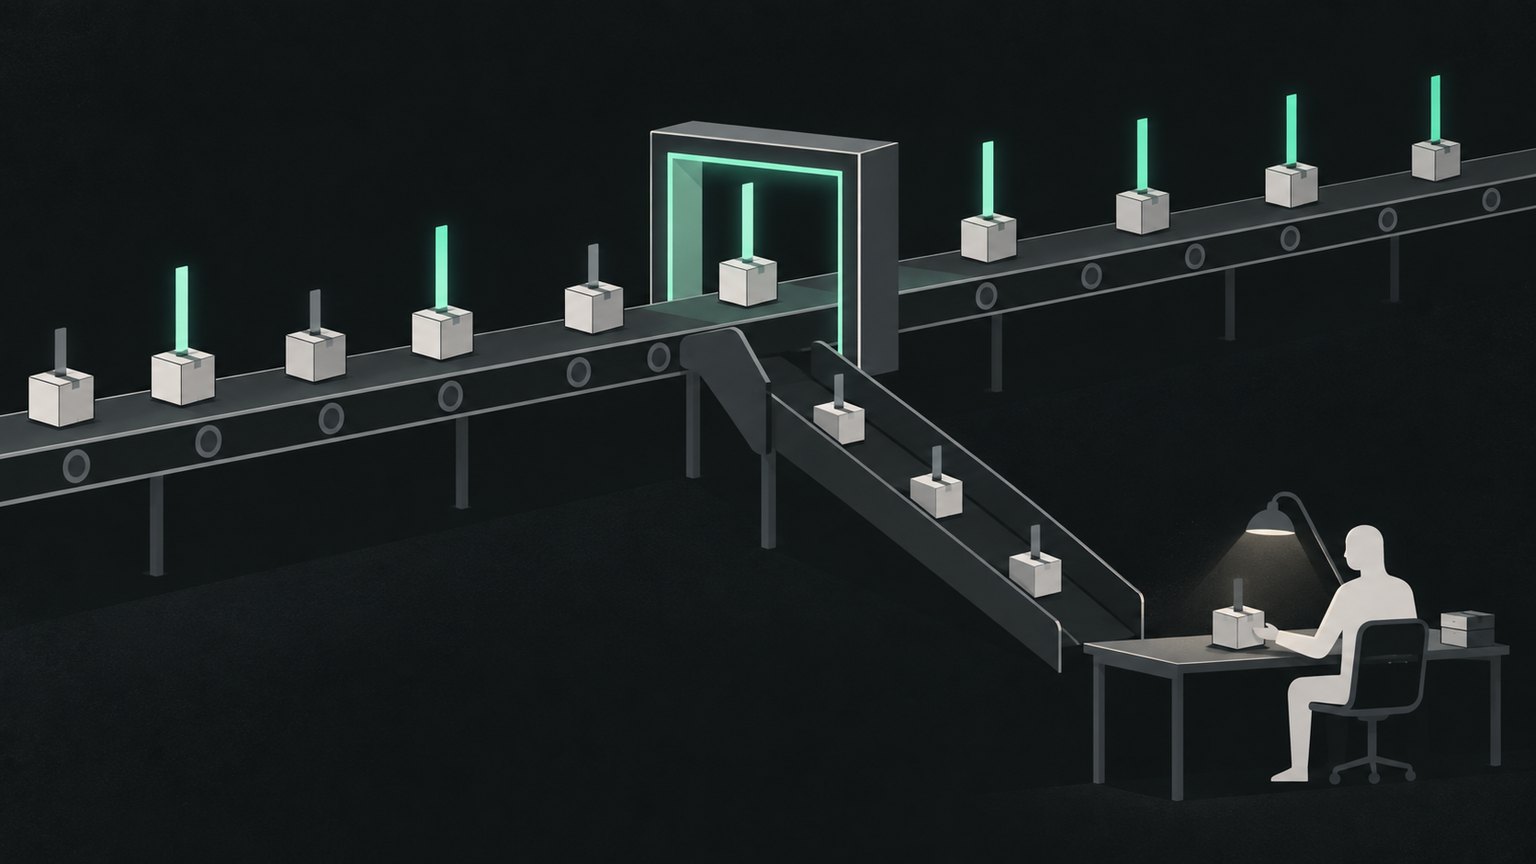
O que permite calibrar um corte e confiar nele semana que vem
Medindo a mesma pergunta 15 vezes, o desvio padrão do Jev ficou em 0,0102, abaixo de todas as condições de LLM testadas, com latência média de 111ms contra 1,1 a 13,9 segundos.
Ele não é só mais barato: ele repete a mesma resposta. Um corte calibrado hoje continua valendo depois.
Repetir a mesma resposta não é acertar. São duas medidas diferentes.
A métrica que quase toda avaliação de portão esquece
Contar acerto médio esconde justamente o erro que o portão existe para evitar. O que falta é contar separadamente as vezes em que o sistema agiu quando devia ter se abstido.
Não é invenção minha: é assim que a trycua avalia os modelinhos de decisão dela, com seis colunas separadas (acurácia, abstenção, cobertura, ação errada, alvo errado, e ação tomada quando o esperado era abster). Se você vai ligar um portão, meça essas duas últimas desde o primeiro dia.
Onde usar: o padrão do funil
Este é o desenho que resume o uso inteiro, e não é meu: é o do Nate Herk.
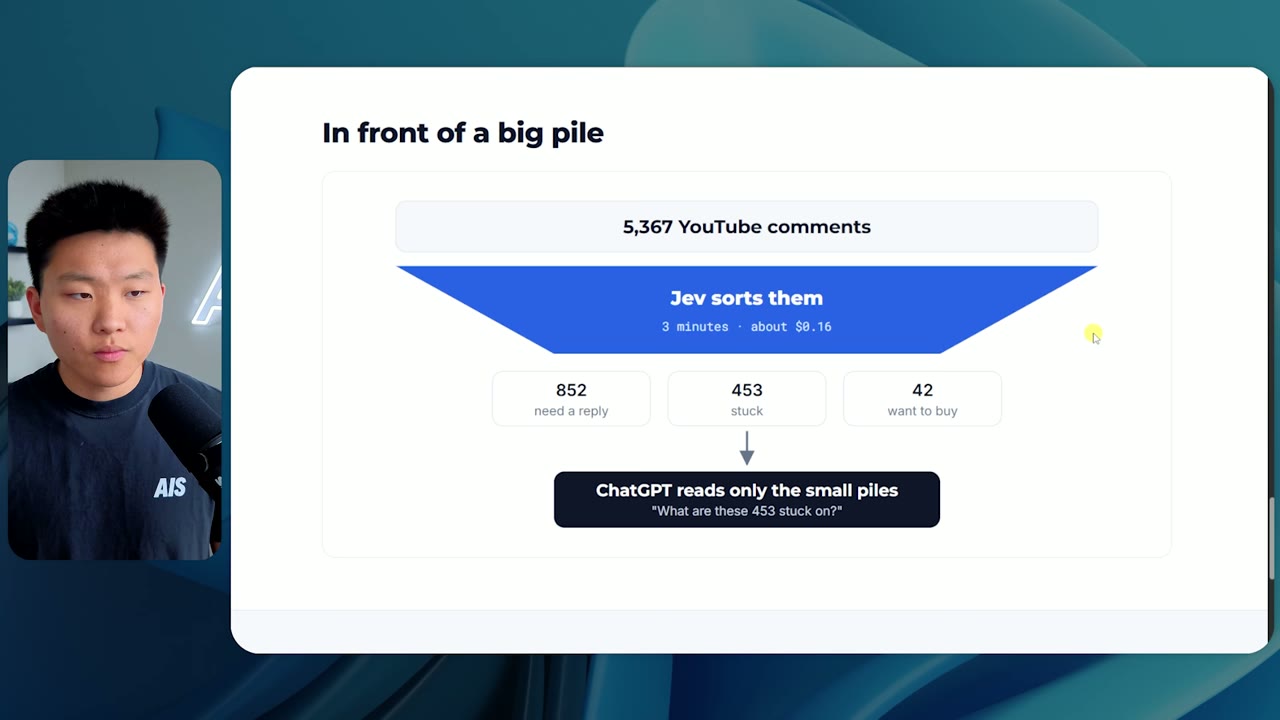
classifique isso, é
o que travou estes 453?.
O modelo caro nunca some. Ele só para de ler o que ia ser descartado.
Quando puxar cada um
puxe o Jev quando
- são milhares de itens
- alguma coisa espera a resposta
- uma pessoa confere os casos duvidosos
fique no modelo grande quando
- são poucos itens
- você precisa do porquê
- errar sai caro
O caso central: roteamento de agente
Aqui está o encaixe mais direto com o que a casa faz, e o único onde já existe número de terceiro.
- harness
- O programa que segura o modelo e roda o laço em volta dele. Ele carrega as instruções, escolhe a ferramenta, executa e devolve o resultado pro modelo. O Claude Code é um harness. A Lain roda dentro de um.
Os três harnesses têm o mesmo problema
| harness | como escolhe a skill hoje | o custo disso |
|---|---|---|
| OpenClaw | compila as skills elegíveis num bloco XML dentro do system prompt, cerca de 97 caracteres por skill | quando estoura o teto, ele corta: encurta as descrições e, se ainda não couber, omite a descrição e deixa só o nome |
| Hermes (Nous Research) | a lista de skills vai no system prompt, cerca de 3 mil tokens, com a descrição cortada em 60 caracteres | o preâmbulo manda na dúvida, carregue, então ele carrega demais |
| a Lain | o índice das 56 entries dentro do CLAUDE.md |
carregado em todo turno de toda sessão, custando contexto e um modelo caro por decisão |
É o mesmo desenho nos três: joga o catálogo inteiro no prompt e pede pro modelo grande escolher lendo a lista. Não existe etapa de roteamento dedicada em nenhum deles.
O custo foi medido, no Hermes
A TypeSafe rodou o experimento no catálogo real do Hermes: 182 skills, 488 pedidos de teste. Dos 488, 315 tinham exatamente uma skill certa e 173 não tinham nenhuma, de propósito, pra punir chute.
Duas taxas de erro, as duas quanto menor melhor:
| braço | carregou a skill errada | carregou skill sem precisar |
|---|---|---|
| o agente sozinho, só com o catálogo | 16,8% | 9,8% |
| com o Jev sugerindo na frente | 7,3% | 4,0% |
| entregando a resposta certa de bandeja | 2,5% | 1,2% |
Mesmo recebendo a resposta certa, o agente nem sempre carrega a skill. O piso de erro não é zero.
Um detalhe que diz muito: das 36 primeiras escolhas erradas do agente sozinho, 10 foram dentro da categoria certa. Ele já olha no lugar certo. O difícil é separar sósias.
Como eles fizeram, em duas chamadas
- Peneirar o catálogo inteiro. Um
choicesobre as 182 skills, usando como critério a mesma descrição curta que o agente já vê. Junto, trêsnoulperguntando de ângulos diferentes se o usuário quer uma AÇÃO e não uma explicação. Se a média das três ficar abaixo de 0,30, não sugere nada e fica quieto. - Reavaliar só os 3 primeiros. O mesmo
choice, agora com a descrição completa mais os primeiros 700 caracteres do arquivo da skill. Mais umnoulpor candidato:esta skill faz exatamente a coisa pedida?
. Se o maior ficar abaixo de 0,30, descarta a lista toda.
O pedido: monta um pitch deck em pptx
.
Na primeira passada, com 60 caracteres de descrição, a skill que edita pptx ganha da que cria pptx. Na segunda passada, com o corpo do arquivo, vira para a certa.
O pedido: posta isso no Mastodon
.
O catálogo tem skill pro X e nada pro Mastodon. As três perguntas acertam que o usuário quer ação, o ranking entrega a skill do X, e a segunda chamada não salva, porque ela só pode rejeitar o que a primeira lhe entregou. Ranking nenhum resolve a falta de uma skill.
Dois detalhes de projeto que valem roubar
A sugestão entra em uma linha, DEPOIS do catálogo, nunca dentro dele. Mexer no meio do catálogo quebraria o cache de prefixo e deixaria cada turno mais caro.
- cache de prefixo
- O provedor guarda o começo do prompt já processado e cobra menos por ele. Mexer no começo joga o desconto fora.
A frase diz explicitamente ignore isto se não servir
. Eles testaram: pressionar mais aumenta a obediência às sugestões erradas também. E uma sugestão errada e confiante é pior que nenhuma sugestão.
O que eu medi na Lain
Mesmo desenho, catálogo da casa: 56 entries, 116 pedidos de teste. A verdade não foi escrita por mim: são os exemplos que o Biel escreveu ao cadastrar cada entry.
Os erros são quase todos ambiguidade real.
O pedido monta a proposta do dr. Fernando
foi pro cliente errado.
É exatamente o tipo de caso que o portão segura antes de errar.
O desenho pra Lain
Jev na frente, modelo da sessão atrás. O Jev rankeia as 56 entries e responde em 0,3s. Acima do corte, a sessão já começa sabendo a entry. Abaixo do corte, o modelo grande decide como sempre fez.
Três ganhos de uma vez:
- O índice sai da janela de todo turno, e vira uma chamada de uma fração de centavo.
- A decisão cai pra 0,3s, contra um turno inteiro de modelo caro.
- A regra da casa vira código. Hoje
duas entries plausíveis viram uma pergunta
é um julgamento. Com as probabilidades na mão, vira um número: se a segunda colocada está perto da primeira, pergunta.
E o 93,1% de acerto no top 2 diz que essa pergunta de desempate quase sempre contém a resposta certa.
Já existe pacote pronto pros dois harnesses, e o que ele faz de verdade
Em 20/09/2026 saiu um manual em português do Denderson (jev-llm.denderson.com), página única com 20 capítulos, com versão em inglês e em espanhol, e dois pacotes de integração para baixar: Naia Hermes (Hermes 0.19.0, Python) e Naia OpenClaw (OpenClaw 2026.9.5, Node).
O código controla o fluxo. O Jev avalia a decisão semântica. O LLM escreve ou planeja.
a tese do manual, que é a mesma deste dossiê
O que os pacotes fazem, de fato: registram uma ferramenta jev_decide que o agente pode escolher chamar. Nenhum hook automático. O plugin declara a ferramenta, uma skill curta ensina quando usar, e o cliente valida a resposta antes de devolver. Liga com hermes plugins enable naia-jev e openclaw plugins enable naia-jev-openclaw, e desliga com disable.
O que o cliente dele faz e o adapter.mjs daqui não fazia: valida campo por campo antes de aceitar. Confere qual modelo respondeu, confere que as chaves das respostas batem com as das perguntas, que o choice está dentro da lista, que o score cai entre 0 e N-1, e que todo número está entre 0 e 1.
HTTP 200 sozinho não significa decisão utilizável.
a regra do cliente dele, que vale copiar
Teto local dos pacotes, mais apertado que o da API de propósito: 24 KB de entrada, 16 perguntas por chamada, timeout de 2 segundos, sem retry, sem cache, sem log de conteúdo. E a ferramenta é declarada advisory_only: confiança não autoriza ação.
Os dois pacotes avisam que a sintaxe e o registro foram conferidos, mas que não foram instalados numa conta de aluno de verdade.
E o desenho de hooks do caso real não vem com código: nem nome de hook, nem arquivo. Quem quiser repetir escreve tudo.
Na instância de Hermes dele o Jev entra em dois momentos, descritos em prosa:
- Preparação de turno. Uma chamada agrupada avalia intenção, skills elegíveis, família de ferramenta, tamanho da tarefa, persona e necessidade de fonte. A sugestão só entra no contexto quando bate critério local, e não remove ferramenta do catálogo.
- Observação depois da geração. Resultado de ferramenta vira evidência, sem chamar o Jev a cada ferramenta. Ele é explícito de que isto não é barreira: o texto já pode ter sido transmitido quando a checagem roda.
Ele mesmo desarma a leitura fácil: isso comprova uso e latência naquele experimento, não houve A/B suficiente para atribuir economia, e não se multiplica a média por 15 para estimar atraso sem saber o paralelismo.
O caso do OpenClaw, que é o alerta
Almeida citou o OpenClaw pelo nome como o exemplo do que não fazer: a lição que ele não seguiu foi ter humano no laço.
O OpenClaw é um agente autônomo de código aberto que virou fenômeno (247 mil estrelas no GitHub). Roda dentro do WhatsApp ou do Telegram e tem acesso a e-mail, calendário e mensagem. A equipe de segurança da Cisco testou uma skill de terceiro e encontrou exfiltração de dados e injeção de prompt sem o usuário perceber.
O ponto aqui não é condenar o projeto. É que ele já tem as portas certas, e elas são manuais: dá pra marcar uma skill como o modelo não pode escolher esta sozinho
(disable-model-invocation), ou despachar direto pra uma ferramenta sem passar pelo modelo (command-dispatch: tool).
Um roteador barato e calibrado transforma essas portas manuais numa política automática: abaixo de tal confiança, nada de ação irreversível.
O segundo cérebro: achar a nota certa num vault de milhares
A pergunta que gerou esta seção: dá pra ligar um LLM num vault gigante do Obsidian e usar o Jev pra apontar qual nota tem a informação?
Dá, e é um dos usos que eles documentaram com número. Mas tem uma inversão que precisa ficar clara antes.
O Jev não busca no seu vault. Ele escolhe entre o que você já achou.
a inversão que decide o desenho inteiro
Ele lê 32 mil tokens por chamada. O vault do Biel tem 1.312 notas e 9,1 milhões de caracteres, uns 2,6 milhões de tokens. É quarenta vezes o que cabe. Então alguém precisa peneirar antes.
O desenho em três camadas
- Camada 1, busca rápida. Qualquer método que rode no vault inteiro rápido: busca por palavra, BM25, embedding, ou a busca do próprio Obsidian. Ela não precisa acertar a ordem, precisa só não deixar a nota certa de fora.
- Camada 2, o Jev reordena. Uma pergunta de sim ou não por candidato:
esta nota responde a esta pergunta?
. A resposta é um número de 0 a 1, e você ordena por ele. As 30 chamadas rodam em paralelo. - Camada 3, o modelo grande. Ele lê três notas em vez de trinta, e escreve a resposta.
O número, no caso difícil deles
Eles rodaram isso num conjunto de 3.565 trechos de decisão judicial, com 40 perguntas. A busca rápida sozinha punha a resposta certa em primeiro lugar em 5% dos casos. Com o Jev reordenando:
| onde a resposta certa apareceu | só busca rápida | com o Jev reordenando |
|---|---|---|
| em primeiro lugar | 5% | 18% |
| entre os 5 primeiros | 15% | 35% |
| entre os 10 primeiros | 38% | 62% |
É texto jurídico, que é o caso mais difícil que existe: linguagem parecida, dezenas de trechos quase idênticos.
O seu vault é mais fácil (são as suas notas, na sua língua, sobre os seus assuntos). Mas a lição vale: ele melhora muito e não resolve sozinho.
A limitação que decide tudo
O que a busca rápida não trouxer, o Jev nunca recupera. Ele só reordena a lista que recebeu.
No teste deles, a busca rápida trazia a nota certa entre as 30 em 100% das perguntas. Por isso o reordenamento tinha o que fazer. Se a sua busca deixa a nota de fora, nenhum reordenamento salva.
É o mesmo caso do posta isso no Mastodon
da seção anterior: quando a coisa certa não está na lista, a segunda passada só pode rejeitar, não inventar.
Duas perguntas extras que valem de graça
Como todas as perguntas vão na mesma chamada, estas saem sem custo real:
O vault tem resposta pra isto? É o que permite o sistema dizer não tenho nota sobre isso
em vez de entregar a nota menos ruim com cara de resposta.
Esta nota é sua ou é recorte de terceiro? No vault do Biel isso é concreto: tem 01 - Refs cheio de material de fora e tem nota autoral. Saber qual é qual muda o peso da resposta.
Outras que encaixam no mesmo lugar: esta nota está desatualizada?
, isto é anotação crua ou conclusão fechada?
, isto é sobre o negócio ou sobre a vida pessoal?
.
A variante que dispensa índice
Tem um caminho mais direto, e ele vem do experimento com o catálogo do Hermes.
Uma pergunta de escolha aguenta 182 opções confortavelmente. Se você usar só o título mais uma linha de descrição de cada nota, as 1.312 notas do vault cabem em umas três chamadas. Rankeia cada bloco, junta os vencedores, e roda a segunda passada em cima deles.
Dá pra fazer busca semântica no vault sem montar banco de embedding nenhum.
sem índice pra manter, e sem reindexar quando uma nota muda
É o mesmo problema do Hermes: título sozinho não separa sósia. Duas notas com título parecido só se distinguem na segunda passada, quando você manda o corpo junto.
Onde isso já encosta no que a casa tem
O vault já é operado pela casa: tem CLI do Obsidian, skills de busca e de leitura, e as bases que agregam por pasta. A peneira da camada 1 já existe. O que falta é a camada 2, e ela é uma chamada.
Vale o aviso da seção Como sair na frente: monte trinta perguntas cuja nota certa você já conhece, e meça.
É barato, e é a única forma de saber se no seu vault o ganho é o deles.
O verificador contínuo: checar se o agente terminou mesmo
A terceira aplicação estrutural, ao lado do roteamento e do segundo cérebro. Apareceu no X em 19/09/2026, com Elvis Saravia, e ataca o problema mais caro de agente longo: o agente dizer que terminou quando não terminou.
- verificador
- Um segundo modelo, separado do que faz o trabalho, cuja única função é dizer se o resultado bate com o que foi pedido. Não escreve, não corrige, não continua a tarefa. Só responde sim ou não.
- System One e System Two
- Os nomes que a TypeSafe usa. System Two é o modelo que pensa, escreve e executa (o Opus, o GPT). System One é o que só decide, em milissegundos (o Jev). A tese desta seção é combinar os dois: o caro faz, o barato confere.
O que ele fez
Saravia mantém um harness próprio, com uma funcionalidade de /goal: você declara o objetivo e o agente trabalha até cumprir. O problema conhecido desse desenho é que quem decide que o objetivo foi cumprido é o próprio agente.
Ele pôs um verificador de Jev nesse lugar. Depois de cada turno, uma checagem: o objetivo está cumprido? Antes isso era feito por um modelo de raciocínio caro, e por isso rodava pouco. A frase dele: a verificação contínua ficou barata o bastante pra escalar, e por isso dá pra rodar mais verificadores, com mais frequência, pra manter o agente na linha.
System One models are perfect for verification.
Elvis Saravia, no X, em 19/09/2026
Ele chama isso de escalar o harness combinando System One e System Two de forma esperta, aposta que destrava uma leva nova de métodos de test-time compute, e resume o conjunto como um destravamento insano para agente de horizonte longo.
- test-time compute
- Gastar mais computação na hora de responder (mais tentativas, mais conferência) em vez de treinar um modelo maior. Verificação barata é o que torna isso viável em escala.
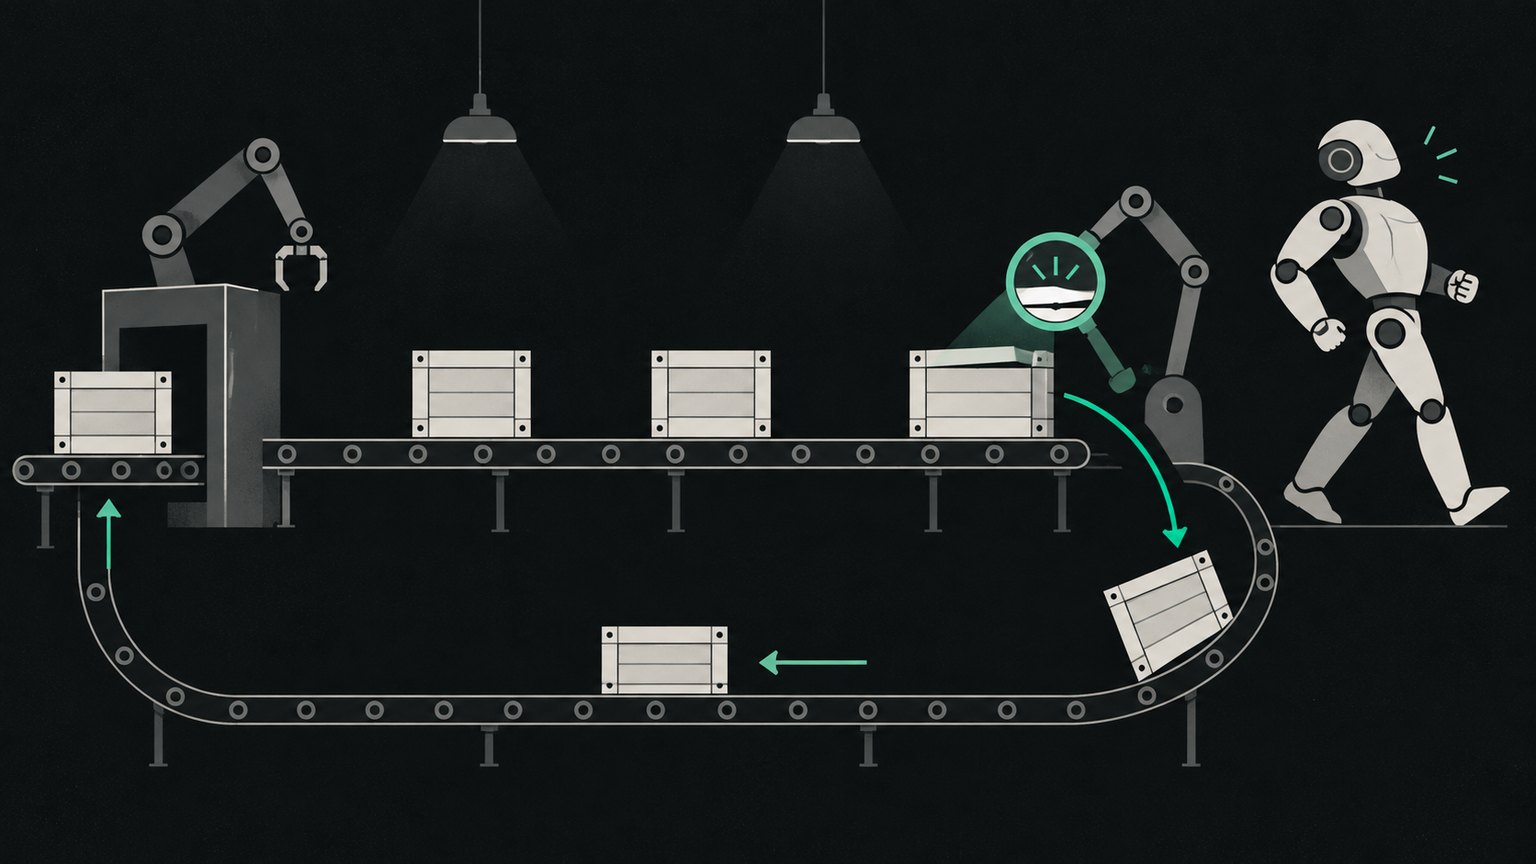
Onde enfiar a checagem: no terminei
, ou a cada passo
Perguntaram exatamente isso na thread, e a resposta é honesta:
- hoje ele checa quando o agente afirma que terminou. É o uso seguro.
- checar a cada par de passos é tentador porque é barato, e ele diz que tem curiosidade de testar. Não testou ainda.
Um leitor que já rodava a checagem barata no terminei
contou que ela pegou os términos falsos, mas que a checagem a cada turno começou a derrubar passos que o agente precisava tentar para chegar lá.
A pergunta dele: a sua alguma vez matou uma execução que teria dado certo sozinha?
A resposta de Saravia: precisa ser medido direito, e não existe benchmark bom para isso ainda.
A cada passo, um verificador impaciente vira um chefe que interrompe. O caminho conservador é checar no terminei
, e só depois medir se checar mais cedo ajuda ou atrapalha.
As ressalvas dele, que valem tanto quanto a ideia
- Isso é para quem tem harness próprio. Ele mesmo diz que pode não fazer sentido para quem usa o
/goalde fábrica do Codex ou do Claude Code, e que vai demonstrar com o Pi porque o harness dele não é público. - Ele acabou de começar. Os primeiros resultados são bons, e ele ainda precisa achar como medir. Nenhum número foi publicado.
- Ele chama isso do caso de uso mais chato do Jev, de propósito: as demos espalhafatosas e irreais do X nunca chegam em produção, e o que eleva resultado é o uso sem graça.
O desenho pra Lain
A casa já tem o lugar exato, e ele está escrito: as done criteria de cada entry, em .lain/entries/<id>.md. Hoje quem decide se foram cumpridas é o modelo da sessão, no fim do trabalho, lendo o próprio relato. É o juiz julgando a causa dele.
O desenho: quando um despacho volta, um noul por critério de conclusão, com o estado sendo o relatório do subagent mais a lista de arquivos que ele tocou.
- acima do corte, o trabalho está entregue
- abaixo, a Lain reabre aquele critério específico antes de responder ao Biel
Vale para a regra da prova pelo mesmo motivo: implementei X
sem evidência que se possa conferir é exatamente o término falso que o verificador pega.
Uma chamada de Jev não é um subagent.
a diferença que decide se isso cabe ou não
Não relê o contexto, não reexplora o projeto, não custa a janela duas vezes. Custa três décimos de segundo e uma fração de centavo. É por isso que cabe no fim de todo despacho, e um verificador de modelo grande não cabe.
O ecossistema na primeira semana: o que já dá pra pegar pronto
O Jev tinha menos de uma semana no ar quando isto foi escrito, e já existiam duas curadorias grandes (as duas de 18/09/2026), dezenas de repositórios públicos e integração em três lugares oficiais. Aqui está o que sobrou da triagem.
O que dá pra instalar hoje
É lista de candidato, não recomendação. As estrelas são as do dia em que a curadoria foi publicada.
| o quê | o que faz | como pega |
|---|---|---|
| jev-model-router | mod do Claude Code: a cada pedido, o Jev classifica o modelo do subagent, o modelo principal e o nível de esforço | npx claude-code-templates@latest --mod productivity/jev-model-router |
| fast-jev-compaction | compactação de contexto: tira do histórico as chamadas de ferramenta que já não importam | repositório da Tamara Tran, 2.790 estrelas |
| foreman | supervisiona trabalho autônomo de agente de código | 279 estrelas |
| jev-review | revisão incremental de diff | 251 estrelas |
| jev-rules | escolhe que regra e que contexto carregar por arquivo | 3 estrelas, e é o que mais parece com o roteador da casa |
| langchain-typesafe | middleware oficial de roteamento de modelo, da LangChain | pip install langchain-typesafe |
O detalhe do jev-model-router que vale a leitura: ele classifica o modelo principal só no começo da sessão, de propósito, para não quebrar o cache. É a lição da seção 9, aplicada por outra pessoa, sem combinar.
O padrão que se repete em quase todos
Alimente candidatos. Não peça invenção.
o que os quarenta projetos têm em comum
- o agente de browser monta o espaço de ações a partir do DOM a cada passo, e o Jev escolhe o próximo clique
- o buscador traz os trechos como sempre trouxe, e o Jev apaga os que não servem
- o lançador de arquivos rankeia, e o Jev re-rankeia a cada tecla digitada
É a mesma inversão da seção 10, e ela aparece sozinha em projeto de gente que não se conhece. Quando um padrão reaparece assim, ele é da tecnologia, não do autor.
Os números que saíram junto
Todos de terceiros, nenhum medido aqui, nenhum com metodologia publicada.
| o quê | número | quem |
|---|---|---|
| busca de voo dentro de um agente de browser | 7,07s e US$ 0,0039 | Gregor Zunic, do browser-use |
| 500 e-mails classificados | segundos, 3,5 centavos | Riley Brown |
| compactar uma sessão de quase 1 milhão de tokens | 86 mil tokens, em cerca de 1s | Alex Volkov, com o plugin da Tamara Tran |
| revisão de segurança antes de executar | até 18x mais rápido no p95 | time da Vercel |
| linter de prosa, 10 perguntas de sim ou não por parágrafo | 182ms de mediana, e 1 falso positivo em 54 parágrafos limpos contra 37 do Haiku | Dan Willoughby |
| busca em banco de dados em linguagem natural | 129 linhas julgadas em cerca de 1s | a extensão pg-jev |
O linter de prosa é o que mais interessa aqui: é a mecânica da ideia 6 (soa como você ou como IA
), rodada por outra pessoa, e com o falso positivo medido, que é a parte que costuma faltar.
O autor da lista de 30 repositórios escreve no fim dela: confira o custo da API e o envio de dado a terceiro antes de usar, e ele mesmo não testou tudo.
O caso mais claro é a extensão de PostgreSQL, que manda as linhas do seu banco para a API deles. Vale reler a seção 17 inteira antes de plugar qualquer um desses num dado que não é seu.
Os números, com a fonte de cada um
Nenhum número aqui aparece sem dizer de onde veio.
| o quê | número | fonte |
|---|---|---|
| preço da entrada | US$ 0,042 por milhão de tokens | página de modelos |
| preço da saída | zero | página de modelos |
| latência | de 70 a 500ms | docs; medi 164ms no console deles |
| contexto | 64k por requisição, 32k para o texto | página de modelos |
| limite de vazão | 1.200 requisições por minuto | página de modelos |
| velocidade contra LLM | de 20 a 200x mais rápido | anúncio deles (as fontes divergem: o anúncio diz 20 a 200x, um dos vídeos diz 40 a 200x) |
| custo contra LLM | de 40 a 400x mais barato | anúncio deles |
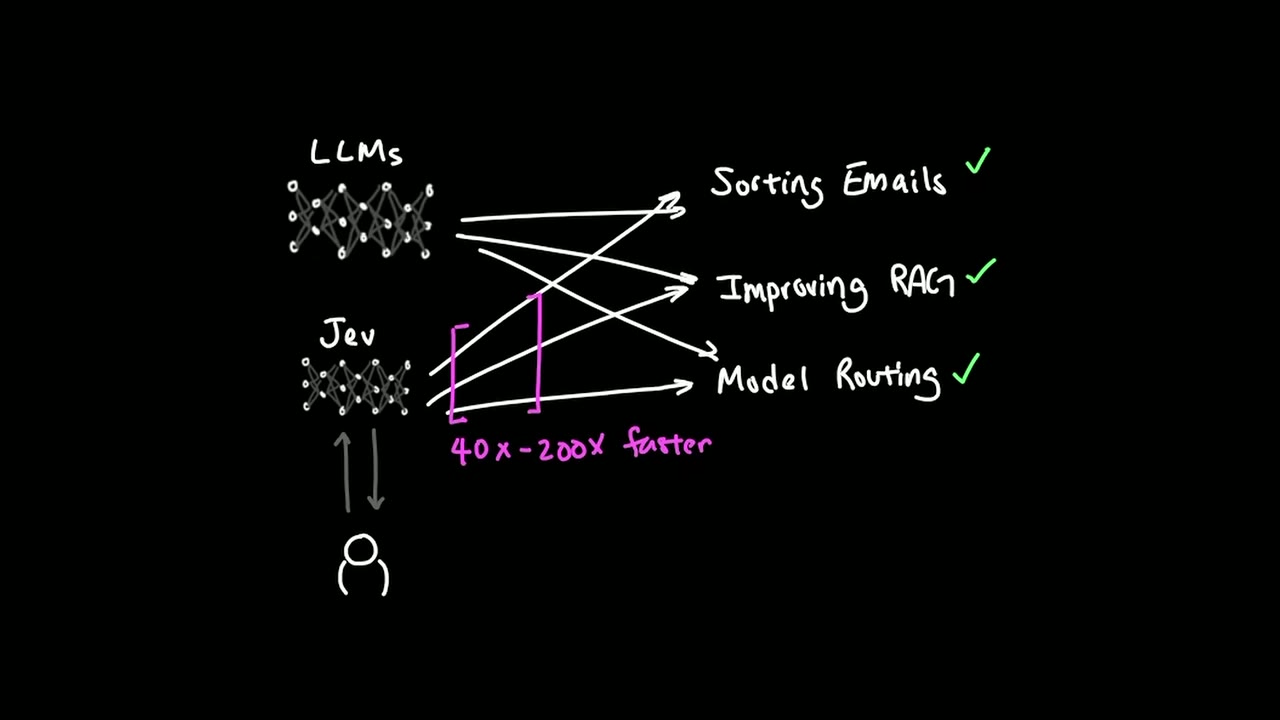
40x a 200x; o anúncio da TypeSafe diz
20x a 200x. A divergência é das fontes, não da leitura.
A calibragem honesta das manchetes de velocidade
A melhor formulação que li é de Manish Choudhary, depois de ele ler mais de dez artigos e cinco horas de vídeo. Os três números são todos verdadeiros, e o que muda é o que está sendo medido:
É essa a régua para ler tanto o 20 a 200x
do anúncio quanto o 250x
que circulou nos grupos. E o 193,6x que a Vercel repete no changelog dela vem das avaliações da própria TypeSafe contra um modelo de meio de tabela, não contra um de fronteira.
Mike Taylor plantou sete defeitos num texto. O Jev pegou seis. O modelo de fronteira pegou os sete, levando 25 vezes mais tempo.
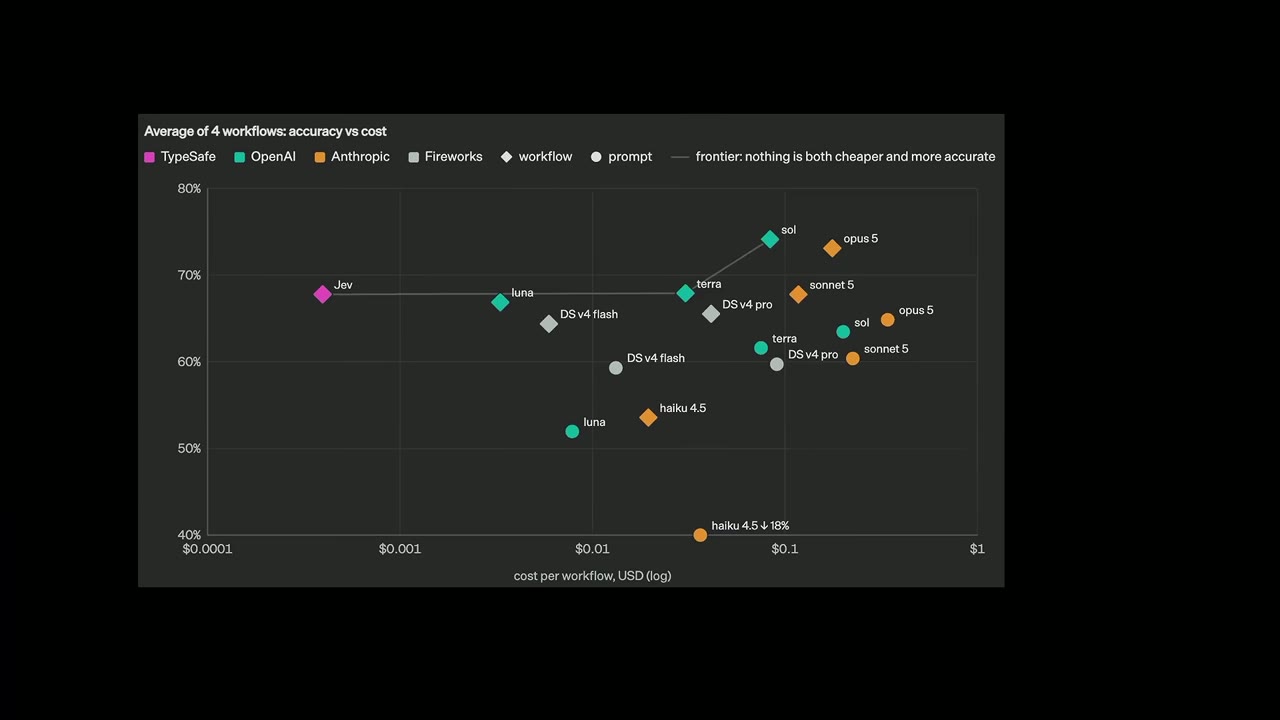
E no benchmark de quatro fluxos da própria TypeSafe, o Jev tira 67,8%, empatado com o GPT-5.6 Terra e alguns pontos atrás do Sol e do Opus 5.
Medidos por terceiros
O único benchmark independente de verdade, do Greg Pstrucha, num pipeline de segurança que ele já rodava em produção:
| modelo | acerto | latência | custo por mil |
|---|---|---|---|
| TypeSafe Jev | 99,3% | 0,259s | US$ 0,026 |
| Gemini 3.1 Flash-Lite | 99,3% | 1,338s | US$ 0,372 |
| Gemini 2.5 Flash-Lite | 97,4% | 0,616s | US$ 0,071 |
| Qwen3 Next 80B A3B | 97,1% | 0,745s | US$ 0,119 |
| Gemini 2.5 Flash | 97,4% | 0,755s | US$ 0,239 |
| GPT-OSS 120B | 96,4% | 1,821s | US$ 0,080 |
| Gemini 3.7 Flash | 96,4% | 2,098s | US$ 0,769 |
Outros, de terceiros
- 1.000 e-mails, 7 classificações cada: 6 segundos e 9 centavos. O mesmo com GPT 5.6 Luna: 5 minutos e 62 centavos. (Nate Herk)
- 20.000 requisições por 85 centavos. (Nate Herk)
- 1.700 e-mails com 4 saídas cada: 18 centavos. (Ryan Vogle)
- Custo mensal a 10 mil decisões por dia: Jev US$ 10, GPT-5.6 Luna US$ 55, GPT-5.6 Sol US$ 1.080, GPT-6 Astra US$ 2.700. (painel do Nate Herk)
- Medidos pelo Denderson, no manual dele, cada um com a ressalva escrita por ele: no caso real do Hermes, 15 chamadas numa tarefa de construção de site, média de 908ms, sem A/B suficiente para atribuir economia; e duas chamadas reais feitas na edição do próprio manual, 778ms com 709 tokens de entrada e 917ms com 546 tokens, a primeira com confiança 0,84. A conta de 37,5% de economia que aparece no manual é declaradamente simulada, não medida.
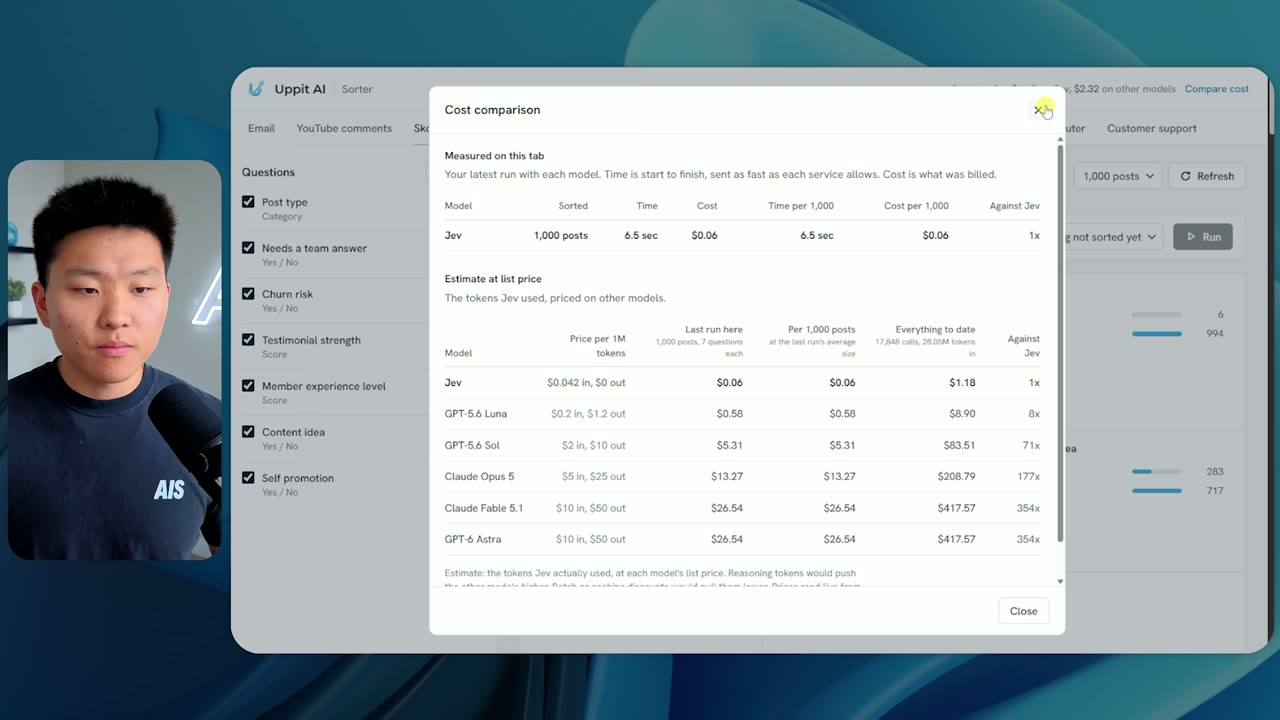
Medidos por mim, no workspace
O que ele NÃO faz
Esta seção evita a maior parte da frustração.
- Não escreve nada. Nem uma palavra. Precisa de texto? O Jev decide e outro modelo escreve.
- Não resume, não acha tema, não faz análise aberta. Ele não olha 1.000 transcrições e diz o que está errado nas suas calls. Ele responde 1.000 vezes a pergunta que você escreveu, e você lê o resultado e tira o tema.
- Não extrai valor, escolhe entre valores. Ache os candidatos com código ou com outro modelo, e deixe o Jev escolher qual é o certo.
- Não conta, não faz conta, não compara data. Aritmética fica no código. Pra data: extraia as partes (mês, dia e ano são conjuntos pequenos e fechados) e monte a data você.
- 64k de contexto, contra o milhão dos modelos grandes. Filtre antes de mandar: a acurácia cai quando o texto vem cheio de coisa que não interessa à pergunta.
- Ele é literal. Responde a pergunta que você escreveu, não a que você quis dizer.
- Não vê imagem nem áudio. Só texto.
Quando você olha uma resposta errada e se pega explicando o que queria dizer, essa explicação é a metade que faltava na pergunta.
a regra deles, que eu confirmei na prática
Não alucina
quer dizer que ele não quebra o formato. Não quer dizer que ele não erra. Ele nunca inventa uma opção fora da lista, mas pode escolher a errada.
Não trata o texto de entrada como hostil por padrão. Texto escrito pra manipular o modelo pode mover a resposta.
Numa tarefa que comprovadamente não tem sinal, ele parou 17 de 20 respostas em exatamente 0,50.
Ele diz não sei
em vez de inventar um palpite.
É revolucionário? A resposta honesta
O que eles mesmos admitem
Esta é a parte que me fez confiar mais neles, não menos. As ressalvas abaixo estão escritas pela própria TypeSafe, no blog de lançamento.
O número da manchete é o teto, não o típico. Sobre os 193,6x mais rápido e 444,6x mais barato, eles escrevem que esperam que estejam no lado mais alto dos ganhos reais.
A velocidade foi medida dos laptops deles, na costa oeste.
Sobre o preço, eles escrevem que não conseguem provar que não é subsidiado.
O zero de alucinação não é medido. A frase deles: o número não é empírico. Ele é deduzido da garantia de formato, não observado.
A avaliação não tem gabarito. A referência de acerto é a média de dois modelos grandes (GPT-6 Astra e Fable 5.1), não a verdade. E os fluxos de teste foram escritos pelo time deles, que admite que algum viés pode existir.
A home diz Versão 0.01
.
Some a isso o que vem na crítica, mais abaixo: não existe paper, nem arquitetura publicada, nem avaliação de terceiro em conjunto padrão.
E tem uma cláusula no contrato que você precisa saber que existe
O contrato deles (o MCA, atualizado em 27/08/2026) proíbe o cliente de publicar benchmarks ou informação de desempenho sobre os Serviços.
Isso foi notado publicamente no X nos primeiros dias. Uma conta respondeu a um resultado publicado dizendo que quem publicou já tinha violado os termos de uso. Outra apontou que a cláusula derruba boa parte do uso acadêmico.
O relatório e este dossiê são exatamente isso. A ideia de mostrar a coluna de centavos numa call de venda é exatamente isso.
Eu não sou advogada e não vou dizer o que você pode fazer.
Uso interno e decisão sua não têm problema nenhum. Publicar comparativo de desempenho com o nome deles é o que a cláusula alcança.
o que dá pra dizer com segurança, lendo o contrato
Se for virar conteúdo, vale ler a cláusula antes. O caminho seguro é ensinar o padrão (o funil, o portão de confiança) em vez de publicar a tabela de quem é quantas vezes mais caro.
O que muda de verdade
Não é capacidade. É preço e latência.
Um LLM sempre conseguiu classificar e-mail. O que ele nunca conseguiu foi classificar todos os seus e-mails, todo dia, por centavos, em segundos.
Isso muda a pergunta que você pode fazer aos seus dados. Em vez de amostrar, você passa o corpus inteiro.
Jev é só um comando de decisão muito inteligente. Como se os classificadores de 2016 tivessem ganhado a inteligência de 2026.
Nathan Flurry, no X
Tem uma segunda, mais curta, que virou a mais repetida: um if de IA.
E tem a admissão do próprio autor. Quando um comentarista do Hacker News escreveu que aquilo é fundamentalmente um modelo de classificação e não um LLM, Almeida concordou, preferindo chamar de zero-shot em vez de instruction-tuned. Quem vende não está fingindo que é outra coisa.
E o principal: ele não substitui o GPT nem o Claude.
O tamanho do barulho
- O post de lançamento passou de 600 mil visualizações.
- O conteúdo de maior alcance não é da TypeSafe: é o artigo Building a Harness with Jev, da LangChain, com 1,5 milhão de visualizações. O ângulo é exatamente o da seção 9 deste dossiê.
- A Vercel publicou que é o modelo de adoção mais rápida da história do AI Gateway: em 24 horas, quase 13% dos times pagantes usando, o dobro da família GPT-5.6.
A crítica, que é justa
Quase todo número que circula é da própria TypeSafe. Até o 194x mais rápido
que a Vercel cita é atribuído a eles, não medido por ela.
Não existe paper, arquitetura publicada nem eval de terceiro em dataset padrão.
Não alucina
é a frase mais superinterpretada do lançamento.
Um LLM comum também devolve resposta estruturada quando você o configura para isso. Essa frase não é de crítico: está no rodapé do infográfico de um entusiasta. O que o Jev tem de diferente não é o formato, é o preço, o tempo e a probabilidade calibrada que vem junto.
Depender de um modelo fechado sem concorrente maduro é risco de ponto único.
Muita demo de fim de semana, pouco dado de produção. A separação aparece em dois meses, quando houver número de retenção e de falso positivo.
Alguém testou triagem de 50 casos históricos, não bateu o corte de 90% que tinha definido, e abandonou o desenho.
É exatamente o que aconteceu comigo no alvo de alcance.
Já tem alternativa aberta, e em dias
- Laya, aberto, no Hugging Face, com quem publicou afirmando que já passou o Jev em velocidade.
- SimpleJev.ai, de Eugene Cheah: biblioteca aberta que pega qualquer modelo do Hugging Face e transforma num Jev, com endpoint de API, rodando em produção.
- Nimble, da Bespoke Labs, no GitHub. E vários outros: NanoJev, Kev, Jever, OpenJev.
- CUA-S1, da trycua, que é um dado diferente dos outros. Não é clone de Jev: é a mesma aposta noutro domínio. São modelos pequenos que decidem sobre elementos de interface (que valor vai no campo, clicar ou deixar quieto) em vez de texto, e eles usam a expressão
System 1
pelo mesmo motivo, dizendo explicitamente que é analogia de engenharia para decisão rápida e limitada, não classificação de arquitetura. Código MIT, pesos abertos no Hugging Face, sem alegação de desempenho. Não existe relação nenhuma com a TypeSafe, nem citação nem parceria: procurei, e o nome deles não aparece uma vez. É por isso que serve de segundo dado. A categoria está nascendo em mais de um lugar ao mesmo tempo, e a versão aberta dela é inspecionável, coisa que o Jev fechado não é.
O que isso significa pra você: o formato provavelmente vira commodity. O que não vira commodity é saber quais decisões da sua operação são decisões fechadas, e ter o conjunto de teste que prova a troca.
Construa em cima do contrato, não em cima do fornecedor.
o adapter.mjs daqui já provou: trocar o motor por trás do mesmo contrato é mudar uma linha
Como usar hoje, na prática
Três caminhos, do mais direto ao mais indireto.
- API direta.
POST https://api.typesafe.ai/v1/systemone, com a chave no cabeçalho e um corpo comstate,modelequestions. É o que roda aqui. - SDK de Python ou de JavaScript, que já repete sozinho quando bate no limite.
- Pelos intermediários. OpenRouter, Vercel AI Gateway e Zapier já expõem o Jev, então dá pra usar sem conta na TypeSafe. No Gateway o id é
typesafe-ai/jev, e ele não funciona pelos endpoints compatíveis com OpenAI: precisa da API de evaluation do AI SDK. Entraram também o Cloudflare Workers AI (comotypesafe/jev) e o LiteLLM, que passou a suportar o endpoint deles com contagem de custo (esta via veio de resumo de IA, não de fonte primária: confira antes de contar com ela).
Onde aprender: docs.typesafe.ai/llms.txt é o índice, e qualquer página vira markdown puro botando .md no fim da URL. O console tem um Playground com três casos prontos e mostra a latência real de cada chamada.
Duas coisas do console que valem copiar
- Mande o texto como objeto JSON com campos nomeados e aponte pro campo na pergunta com crase:
`user_message`. É como o exemplo pronto deles faz, e é melhor que mandar texto cru. jev-latesté apelido e hoje aponta projev-1.13.0. Se você calibrar um corte de confiança, fixe a versão, porque o apelido anda.
Não existe nada de graça documentado. As páginas da Vercel mostram o mesmo preço de US$ 0,042 por milhão e um exemplo de resposta com custo cobrado.
Circulou a informação de que alguns gateways estavam com preço promocional zerado, terminando por volta de 25/09/2026. Eu não consegui confirmar isso em fonte primária.
Se a sua conta está zerada, a explicação mais provável é essa, ou crédito da conta. Vale conferir antes de contar com isso.
A mais comum de quem saiu da demo: estouro de limite de taxa (erro 429) sob carga real, principalmente pelos gateways.
O cliente que eu escrevi aqui já repete sozinho com espera crescente quando isso acontece.
Ligar em produção sem quebrar o que já funciona
Três regras do manual do Denderson, que são de operação e não de modelo:
- Rollout em três estágios. Primeiro observação (registra a decisão e não muda nada), depois consultivo (a decisão vira sugestão reversível), e só então seleção automática, quando a comparação sustentar. Intervenção sensível começa em observação, sempre.
- A chave de cache não é o texto. Ela precisa levar junto o tenant, a versão do modelo, a versão das perguntas, o estado normalizado e a evidência.
Mesmo texto
vindo de outra conta não é o mesmo evento, e decisão de autorização não se reaproveita nunca. - Fallback em cinco casos: timeout, 429, 5xx, JSON inválido e confiança baixa. Todos caem no fluxo que existia antes. Retry cego é desaconselhado, e falha em sequência deve abrir o circuito.
Isso só vira economia quando a integração substitui trabalho ou tira contexto do modelo caro. Acrescentar uma chamada de Jev sem mudar o fluxo aumenta o custo e a latência em vez de baixar.
Antes de pôr dado de cliente ali dentro
Você processa dado que não é seu: paciente de clínica, lead, extrato bancário. Então isto não é detalhe.
O que está escrito, e onde diverge
Treinar nos seus dados. A política de privacidade é categórica: não treinam nem ajustam modelo com o que você manda. Mas o contrato diz outra coisa em dois pontos. Ele proíbe incluir dado do cliente em treino sem o consentimento prévio do cliente (ou seja, com consentimento, pode). E trata telemetria (logs, estatísticas, classificações e aprendizados ligados ao uso) como coisa que eles podem processar sem restrição, inclusive pra melhorar o produto. Telemetria é derivada do seu dado e fica fora da promessa.
- Retenção: não existe prazo publicado. Nenhum documento diz por quantos dias guardam. O contrato vai na direção oposta: diz que eles não têm obrigação de guardar e podem apagar quando quiserem.
- Zero data retention existe, em uma linha, e só pra enterprise. Pede-se por e-mail.
- O DPA é público e vale pra todo cliente, porque o contrato o incorpora. Ele traz aviso de incidente em até 72 horas, auditoria uma vez por ano às custas do cliente, e transferência internacional coberta por cláusulas padrão da União Europeia.
As três coisas que eu destacaria pra você
No DPA, o campo de dado sensível transferido está preenchido como não aplicável. E não existe menção nenhuma a HIPAA, a acordo de uso de dado de saúde, nem a dado de saúde em lugar nenhum dos documentos.
Para a Ana e para a Clínica Total, isso quer dizer: classifique o comentário e a DM, que são públicos ou comerciais, e não mande prontuário, histórico clínico, nem nada que ligue uma pessoa a uma condição.
2. Não existe menção a LGPD nem à ANPD, e o serviço é hospedado nos Estados Unidos. A base legal do dado que você manda é responsabilidade sua: o contrato diz expressamente que o cliente declara ter obtido os consentimentos necessários.
3. O teto de responsabilidade deles é o maior entre o que você pagou nos últimos 12 meses e US$ 50. Com o preço deles, na prática:
Detalhe comercial: os créditos comprados expiram, no fim do contrato ou 12 meses depois da compra, o que vier primeiro.
Como sair na frente
O gargalo não é acesso ao modelo. Qualquer um tem em 5 minutos.
O gargalo é saber quais decisões da sua operação são decisões fechadas, e ter o conjunto de teste que prova que a troca funcionou.
- Liste as decisões, não as tarefas. Onde hoje um modelo caro é chamado só pra devolver um rótulo, uma nota, ou um sim ou não. Aqui na casa eu já listei 29 desses lugares.
- Ache a verdade que já existe de graça. A sua planilha de categorias. O que você já respondeu na mão mês passado. O que você já escolheu publicar. Sem isso, você não tem como saber se melhorou.
- Meça antes de ligar. Cem casos, os dois modelos, três colunas: acerto, custo, tempo. Foi o que separou aqui
isto vale ligar hoje
deisto não tem solução
. - As contas, escritas. Tokens evitados são os do baseline menos os do modelo principal com o Jev; a economia é isso dividido pelo baseline; o custo total novo é o modelo principal mais o Jev mais infraestrutura; o acerto é decisões certas sobre decisões avaliadas; e a cobertura automática é decisões aplicadas sem fallback sobre eventos elegíveis. Três armadilhas: compare p50 e p95, não a média; token economizado não vira dólar quando o modelo caro é assinatura e não API; e não mude duas coisas de uma vez, como baixar o nível de raciocínio do modelo junto e creditar a diferença ao Jev.
- Use a confiança como portão desde o primeiro dia. A parte de cima roda sozinha, a parte de baixo continua com você. É o que transforma 84% de acerto em 100% de acerto na metade do trabalho.
A oportunidade comercial
Aparece em dois dos vídeos e encaixa direto no que você vende: a maior parte das automações que os seus alunos e clientes montam hoje queima modelo grande numa etapa de triagem.
Trocar essa etapa é um ganho de custo mensurável e fácil de mostrar numa call, porque a prova é uma coluna de centavos.
As 29 ideias pra casa
Cada uma diz o que a casa faz hoje e o que muda. As marcadas foram rodadas de verdade; as outras não, e estão aqui como lista de candidatas.
- provado que funciona, com número
- provado que NÃO funciona
conteúdo e Business de IA
- 01banco de ideias, ao salvarHoje toda ideia entra igual e vira uma carta no painel. Com isto, cada ideia já entra pontuada em
dá carrossel
,dá reel
,dá newsletter
, e com um aviso deisto parece o que você já postou em agosto
. - 02radar vira pauta provadoJá rodado: 64,3% contra 23% de acaso. O modelo grande continua escrevendo a pauta, só para de ler as 7 histórias que iam ser descartadas.
- 03dedupe do radarHoje o radar junta o que chegou por e-mail e repete história que já saiu ontem com outro título. Uma pergunta resolve:
esta história é a mesma daquela?
. - 04newsletter, o corte da ediçãoMesma mecânica da pauta, aplicada ao que entra na edição de sábado.
- 05carrossel, o slide cumpre a capa?Uma pergunta por slide. A capa promete 5 erros e o slide 4 fala de outra coisa: isso aparece antes de virar PNG.
- 06carrossel, soa como você ou como IA?O motor já tem o voz.md. A pergunta compara o slide com a voz e devolve a probabilidade, e o que ficar embaixo do corte volta.
- 07feed-mock, a capa para o dedo?Hoje o feed-mock mostra a capa entre 6 posts reais e você julga no olho. A pergunta dá a nota antes, e você julga só as duvidosas.
- 08termômetro do XClassificar cada tweet colhido por tema, sem gastar modelo grande numa tarefa que é escolher entre 8 caixas.
- 09prever alcance pela legenda provado que NÃORodado, e não funciona: dois modelos de tamanhos muito diferentes empatam no acaso. O problema é a tarefa, não o modelo. Serve de alerta: nem toda pergunta tem resposta no texto.
clientes
- 10fila de leadsCada lead recebe três notas (urgência, orçamento aparente, encaixe com o que você vende) e a fila se ordena sozinha. O peso fica no código, então mudar prioridade é mudar um número.
- 11proposta contra a callDepois de gerar a proposta, uma pergunta por item que o cliente pediu na call:
a proposta cobre isto?
. O que ficar sem cobertura aparece antes de você mandar. - 12comentário e DM dos anúnciosNos anúncios da Ana e da Clínica Total: separar paciente de curioso de spam antes de alguém abrir o direct.
- 13relatório semanal, o que vira alertaHoje o relatório mostra tudo igual. A pergunta decide quais números merecem uma linha em destaque.
- 14dúvidas dos alunos do Dr. LucasAgrupar as repetidas, que é o que vira FAQ e o que vira aula nova.
- 15triagem do Inbox de arquivos soltosA pasta Inbox existe pra one-off sem casa. A pergunta sugere o domínio de destino e você só confirma.
a casa
- 16o roteador do catálogo provado84,5% de acerto nas 56 entries, e no corte de confiança 0,9 acerta 100% em metade dos pedidos. O Jev na frente, o modelo da sessão só no que ficar abaixo do corte.
- 17guardrail de injeção provado10 de 10 ataques pegos, 0 falso positivo em 120 textos reais. O lugar é a entrada do radar e do coletador de referências.
- 18isto é pedido ou é conversa?A saída
nenhuma
do roteador já faz isso: separabom dia
demonta a proposta do Fernando
sem acordar workflow nenhum. - 19triar backlogCada cartão do quadro contra o que existe no disco:
isto já foi feito?
,isto ainda faz sentido?
. Hoje a triagem é leitura na mão. - 20o doctor, ruído contra quebradoClassificar cada linha de erro em
quebrado de verdade
oubarulho conhecido
, pra saudação só trazer o primeiro. - 21e-mail da casaDecidir se um e-mail merece virar aviso hoje ou pode esperar o resumo.
- 22classificar pasta nova no lain-aprendeAs cinco caixas do CLAUDE.md (agente, skill, cron, projeto, experimento) são literalmente uma pergunta de escolha única.
- 23Todoist, o freio do P1Ao criar tarefa, prever se ela é de 2 a 5 minutos ou se é sapo de dia inteiro, e avisar quando um segundo P1 tentar entrar.
- 24ritual de domingoCada tarefa parada recebe
ainda faz sentido?
e a lista de reanimar sai pronta.
vida pessoal
- 25fechamento do mês provado70,8% na pilha que hoje vira pergunta em lote, e no corte 0,5 resolve 76% dela sozinho.
- 26coletor de imóveisO filtro de preço e metragem já é código. O que falta é o que só está escrito no anúncio: aceita pet, é mobiliado, a foto é de reforma inacabada.
vindas do material de 20/09/2026
- 27o verificador de fim de despachoHoje quem diz que as
done criteriada entry foram cumpridas é o modelo da sessão, lendo o próprio relato. Umnoulpor critério, com o relatório do subagent e os arquivos tocados como estado, e o que ficar abaixo do corte volta antes de virar resposta. É o juiz deixando de julgar a própria causa. - 28roteador de modelo e de esforço por pedidoClassificar qual modelo do subagent, qual modelo principal e que nível de esforço cada pedido merece. Já existe pronto como mod do Claude Code, e o detalhe que ele acertou é classificar o modelo principal só no começo da sessão, para não quebrar o cache.
- 29compactação de contextoTirar do histórico da sessão as chamadas de ferramenta que já não importam, em vez de resumir tudo. O plugin de terceiro levou uma sessão de quase 1 milhão de tokens para 86 mil em cerca de um segundo.